Семнадцатый день NAS. Ящик целые сутки стоял без дела: никто ничего не копировал и не смотрел. А диски пула всё это время писали — больше 50 ГБ за день. Эта запись — как мы искали, кто пишет, и почему дело оказалось не в байтах.
Сутки без дела
Утром открыли «Сервер». Процессор — 1–3 %, память весь день ровно на 6 ГБ, кэш ZFS держится на 30 ГБ. Всё как у машины, которая отдыхает.
Кроме одной линии: запись в пул стоит ровно на ~0,6 МБ/с с полуночи до вечера. Это около 2 ГБ в час, а на сутки — больше 50 ГБ. И «занятость дисков» не опускается ниже 5 %: диски не отдыхают ни минуты.
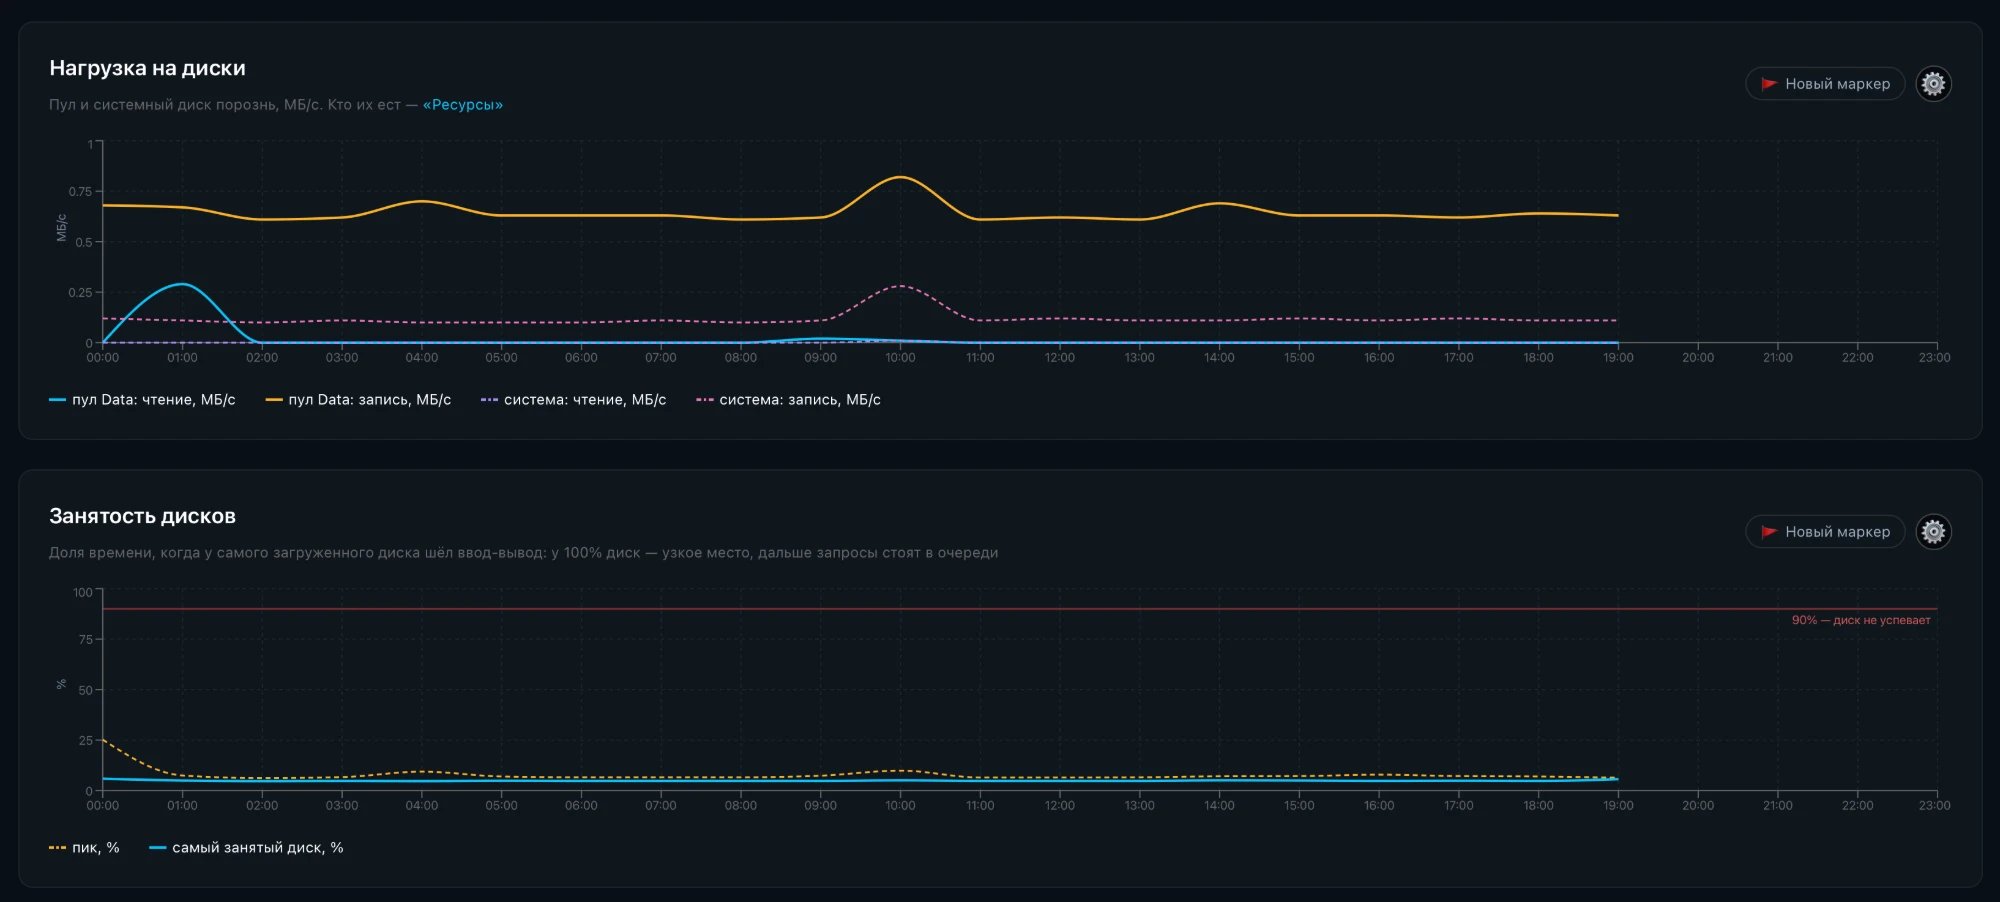
Графики «Нагрузка на диски» и «Занятость дисков» появились накануне — и пул с системным диском на них разведены порознь. Без них этой истории бы просто не было: раньше запись на диски в панели не было видно вовсе.
Кто пишет
Первым делом — «Ресурсы»: там диск разложен по статьям. 55 ГБ записи за сутки ушли в статью «Система», а у базы — 0 МБ.

Подозреваемые
Дальше — по очереди, от самых вероятных. Каждого проверяли цифрами на самом ящике, только чтением.
База. Postgres пишет страницами по 8 КБ, а ZFS хранит файлы блоками по 128 КБ — каждая запись могла переписывать блок в 16 раз больше. Счётчик наборов данных: в набор NAS за минуту — 12 записей и 0,07 МБ*. Мало.
Время доступа (atime). Если оно включено, каждое чтение файла — тоже запись. Проверили: atime* выключен на всех наборах данных.
Служебный набор TrueNAS. В .system живут графики мониторинга, журналы, служебное Samba — и он лежал на пуле. Перенесли на системный NVMe. Запись в пул не упала: 36 МБ в минуту до, 45* после.
Освобождение места, тома, репликация.* Фонового освобождения нет, томов zvol нет, снимки по репликации не принимаются.
Счётчик самого ZFS
У ZFS есть журнал сбросов на диск — каждый сброс с тем, сколько данных в него пришло и сколько записано на диски. За 8,3 минуты — 98 сбросов, пришло 160 МБ, на диски ушло 302 МБ: те самые 36 МБ в минуту.
А по наборам данных за ту же минуту в пул писали всего двое: NAS — 12 записей, докер TrueNAS — 40. Вместе — около 50 мелких записей в минуту, меньше 0,2 МБ данных.
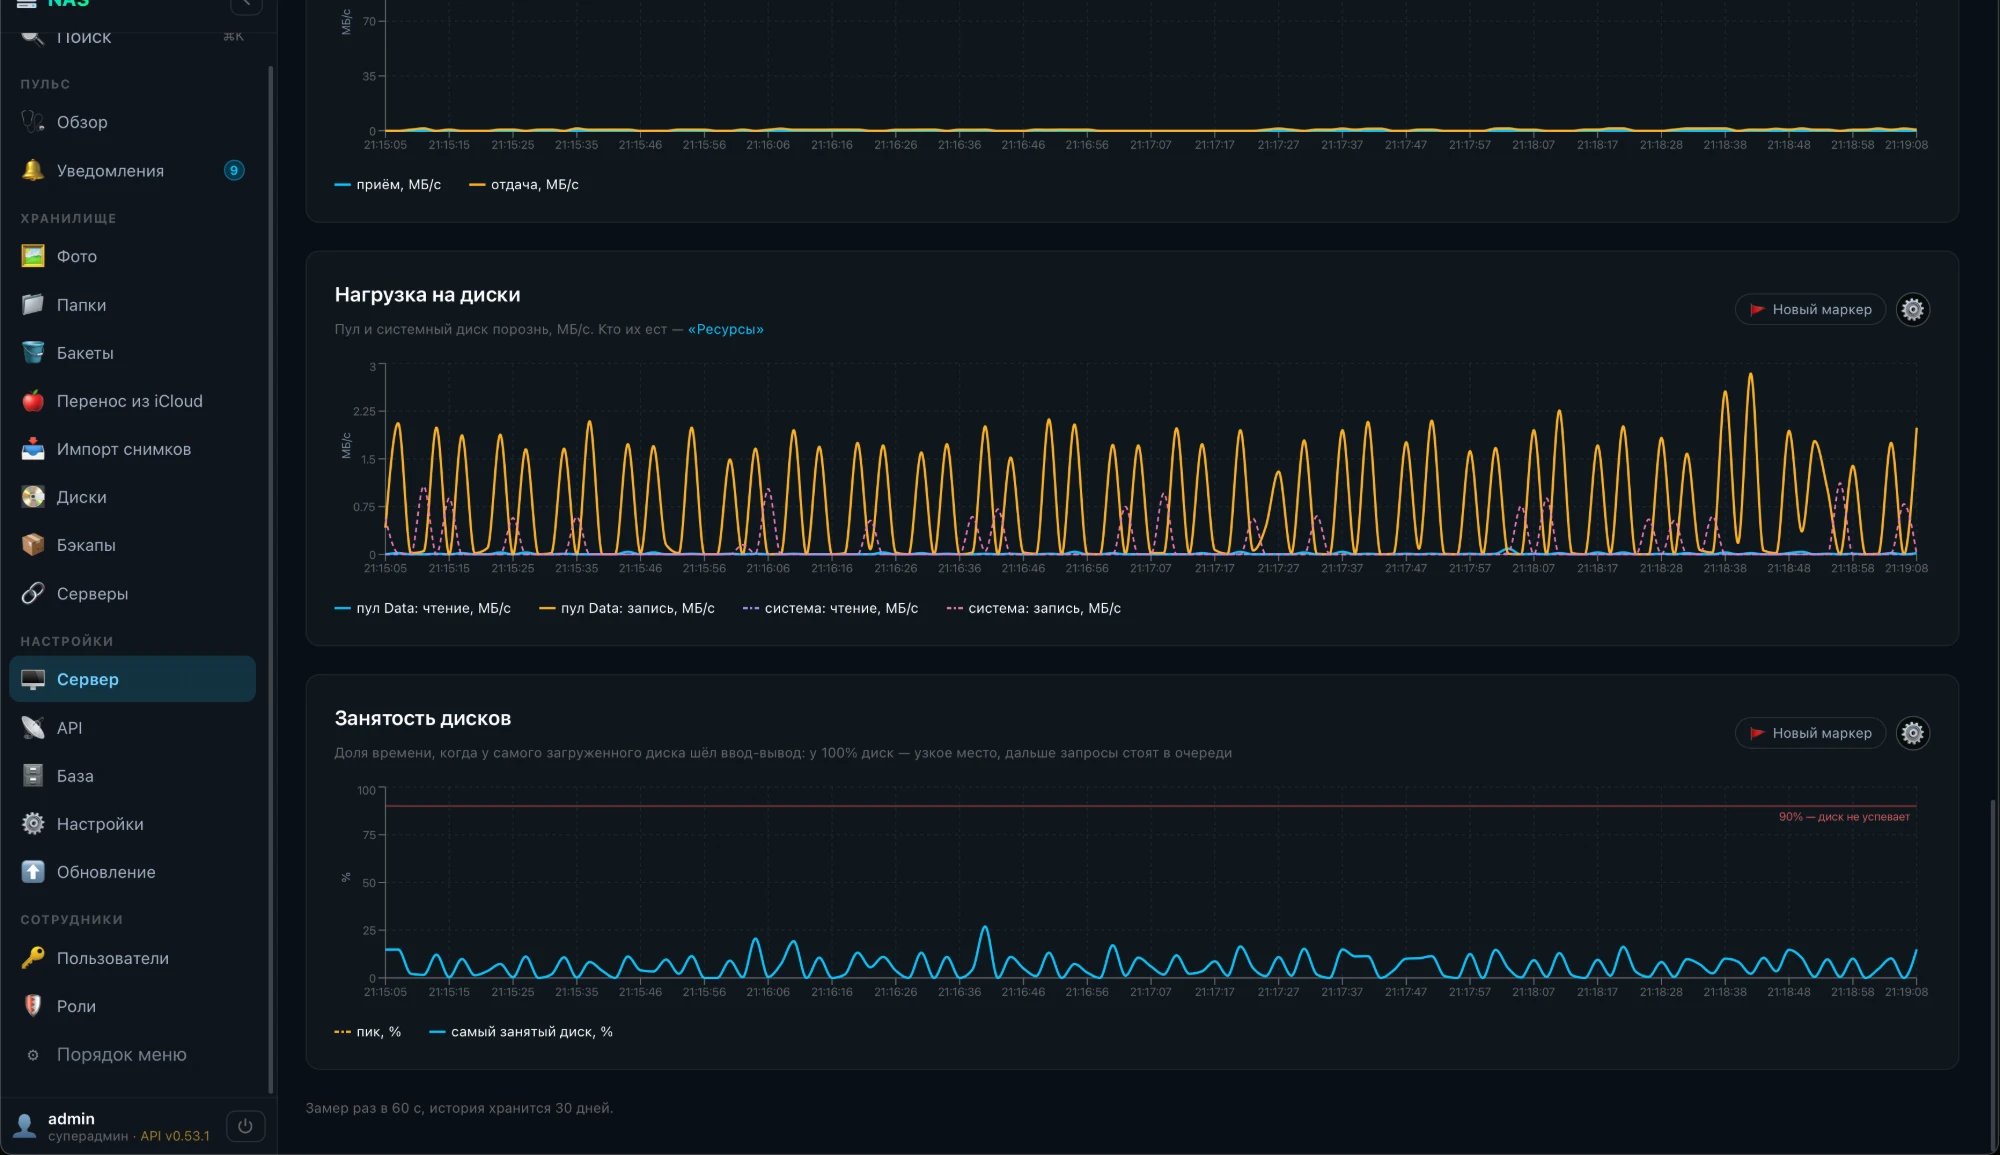
На живом графике это видно сразу: всплески по 2 МБ/с ровно каждые 5 секунд.
Раз в 30 секунд
Рычаг один — сбрасывать реже. Частоту задаёт настройка ядра zfs_txg_timeout: по умолчанию 5 секунд, мы поставили 30. Сначала — пробой, до перезагрузки, потом — постоянно, скриптом при старте TrueNAS.
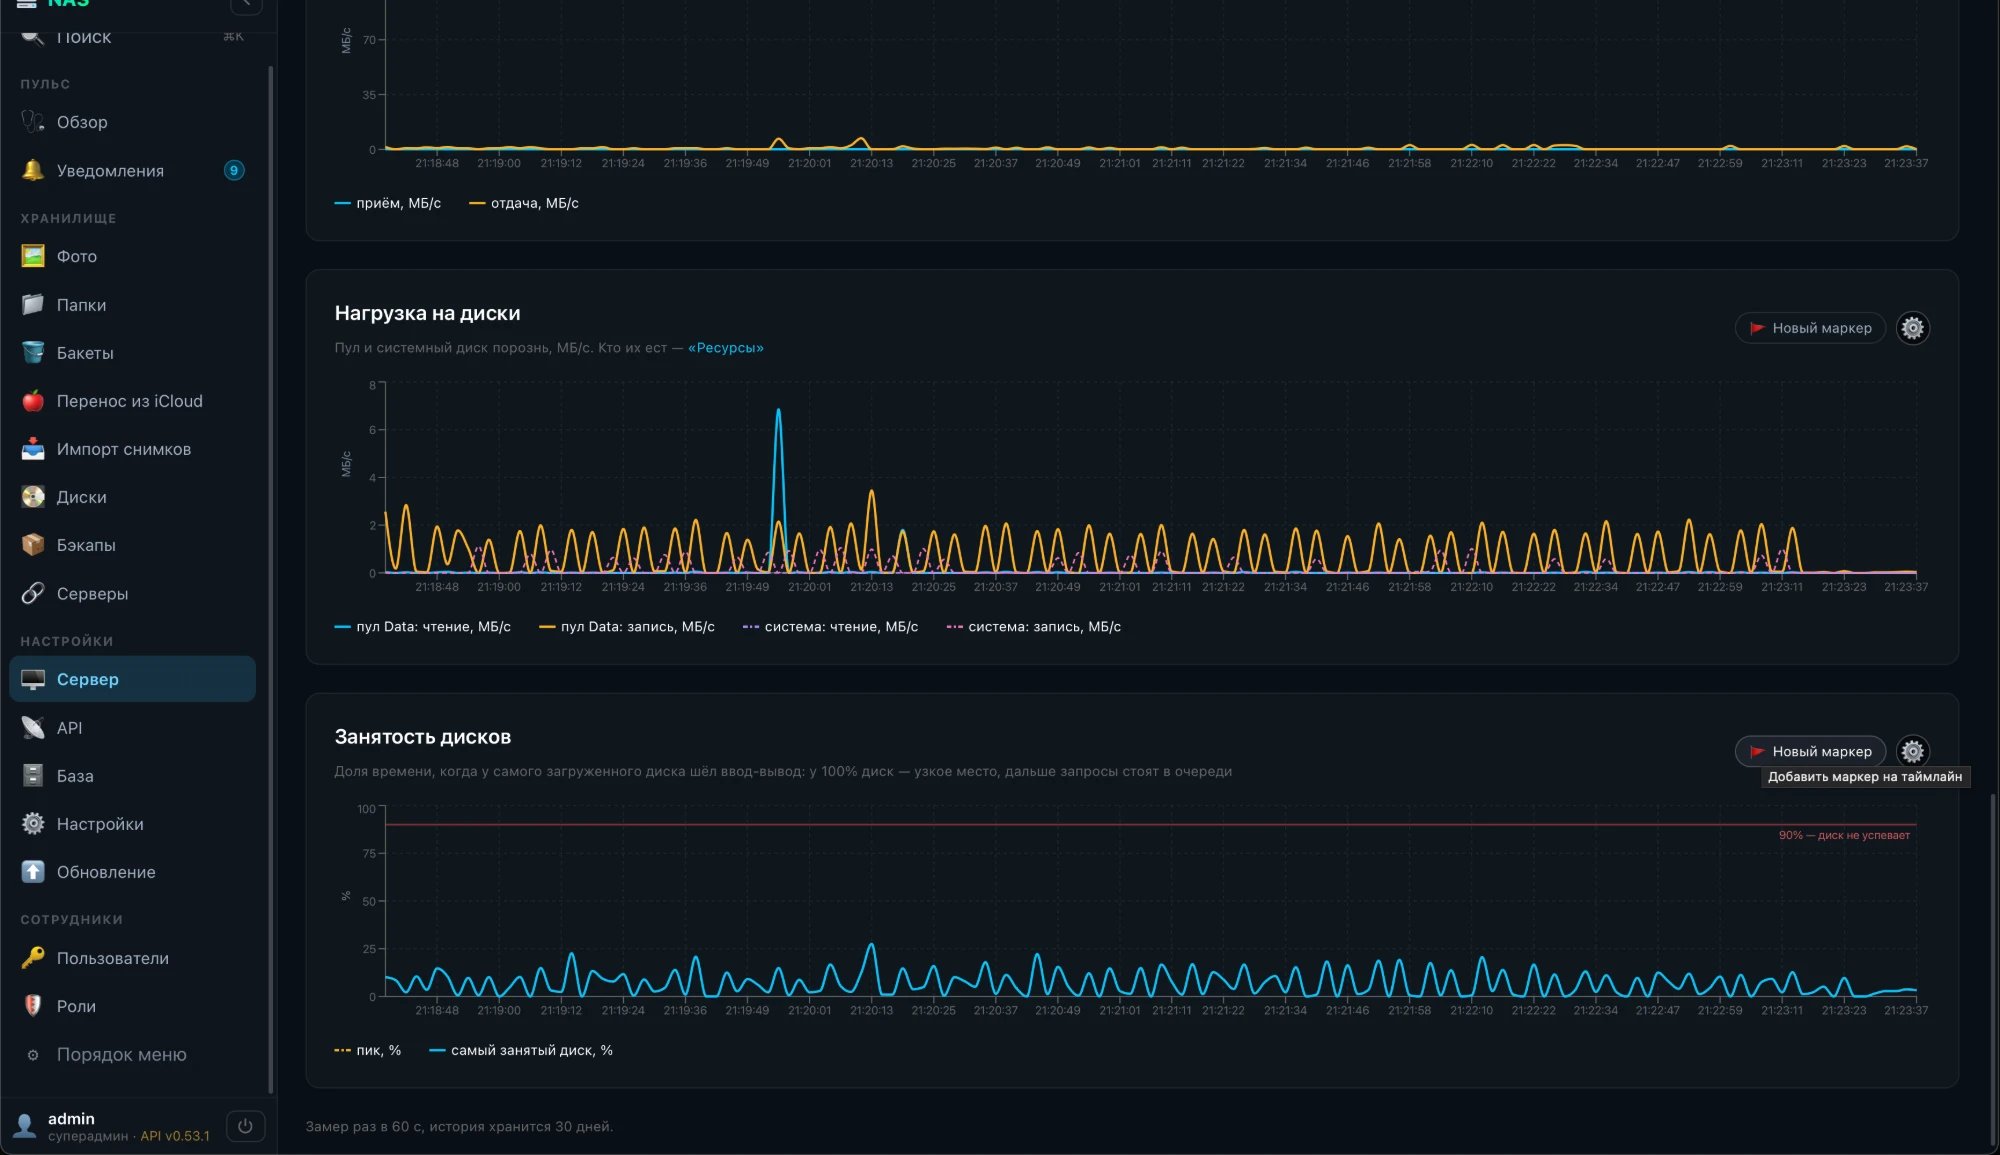
Сбросов стало в шесть раз меньше: 2 в минуту вместо 12. Каждый крупнее, но служебная запись, которая шла с каждым сбросом, теперь бывает в шесть раз реже, а между сбросами диски пула стоят.
А было ли это бедой
Нет. Около 65 ГБ в сутки на весь пул — это примерно 11 ГБ на диск, 4 ТБ в год. Дискам IronWolf производитель закладывает 180 ТБ в год: мы были на 2 % нормы. Это нормальное поведение ZFS на RAIDZ.
Но диски, которые никогда не стоят, — это шум, тепло и износ без смысла. А главное — теперь мы знаем, откуда каждый мегабайт, и видим это на графике, а не гадаем.
Что осталось в панели
- «Нагрузка на диски» — чтение и запись, пул и системный диск порознь, в истории и вживую.
- «Занятость дисков» — доля времени, когда самый загруженный диск работал: у 100 % он — узкое место.
- Плитка «диски» на «Сервере»: сколько читают и пишут прямо сейчас.